由启明创投主办的2026世界人工智能大会(WAIC)“启明创投·创业与投资论坛——从算力原点到应用落地的进化征程”于7月19日在上海世博中心成功举办。
在此次大会上,原力灵机创始人、首席执行官唐文斌发布RoboChallenge全球最新进展,包括具身基础模型排行榜最新成果,CVPR、ICRA等国际顶级学术会议真机挑战赛成果,以及在日内瓦AI for Good全球峰会上正式发布的EAI-Bench最新进展。同时,公布了新一批RoboChallenge国际组委会及生态合作伙伴阵容。依托开放、共享的真机测评平台,连接模型、本体、开发者与产业伙伴,共同打造全球具身智能开放生态,推动中国具身智能技术、标准与生态走向国际舞台。
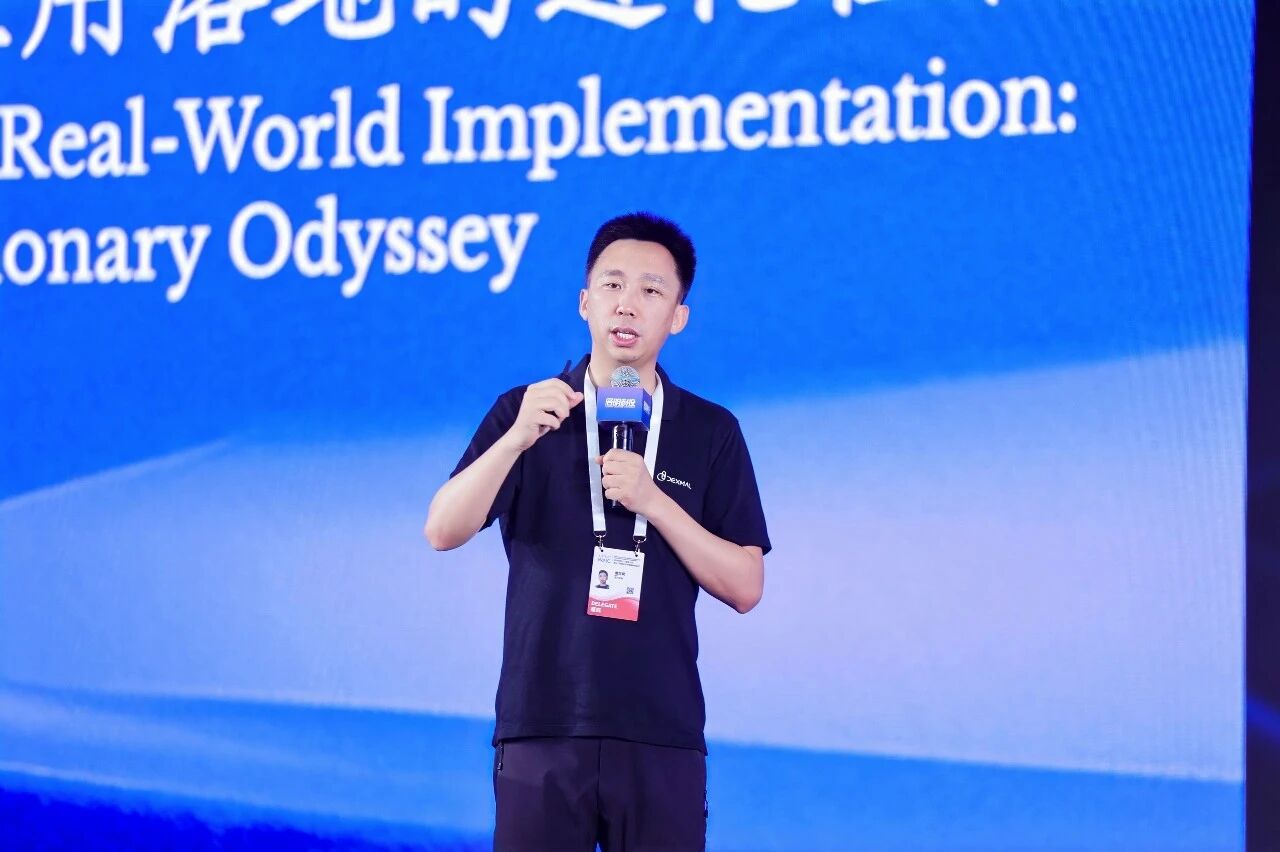
原力灵机创始人、首席执行官唐文斌
唐文斌表示:“原力灵机携手启明创投,将把RoboChallenge打造为一个公益、中立的具身智能评测平台。我们坚持以评测驱动创新,以开放推动标准建设,积极促进产学研深度联动。我们要让更多场景方清晰看到当前具身模型的技术边界,加速推动机器人走进现实。”
以下系唐文斌的演讲精选。
大家好!我是原力灵机的唐文斌,我今天代表的不是原力灵机,而是RoboChallenge,RoboChallenge是我们跟Hugging Face一起发起的一个具身智能的评测平台,先跟大家分享一下,今天我们这个行业到底进展到了哪一步。
今天大家在场馆内,相信也看到了不少实物展示,同时在各类视频里,也见过很多十分酷炫的演示内容。今天的机器到底能做哪些工作?能做到什么样的水平?包括在座很多投资人,你们能判断哪家模型更好吗?坦白讲很难判断,刚刚我们也展示了很多Benchmark,那现在具身智能领域的Benchmark评测又有哪些?有没有榜单呢?其实是有的,我跟大家分享几个。比如说具身领域最有名的评测,一个叫RoboTwin,一个叫LIBERO,现在的成功率是99%,但我们今天的技术水平真的做到99%吗?相信大家心里都有答案,现在还有同行尝试做一些评测和类似于大模型的AB Test,例如Robo Arena就是一个非常好的评测平台,但我们也看到行业出现一些乱象:部分融资规模很高的企业,在平台上进行刷榜作弊,最后被官方取消成绩。
所以今天这个行业,非常需要大家踏踏实实去推动技术的进步,因为没有人会怀疑具身智能巨大的应用前景,但我们必须一步一个脚印往前迈进,所以当下行业需要一个真实、公平、大规模、基于真机、开放的评测体系,这样一套评测体系能够帮助我们客观地去衡量今天技术的进展,促进全行业共创和一起进步。今天这个行业不是靠一家公司做出来的,所有的进步包括大模型上很多的进步,也来自多家企业持续创新,汇聚各方智力,才最终收获好的成果,我想具身智能也是一样的。
所以我们在去年7月份和Hugging Face一起发起了一个项目,叫RoboChallenge,RoboChallenge的目标是打造一个统一的、开放的、大规模的、基于真机的评测平台。大家可以从PPT上看到,我们用了四种科研上比较通用的机型,并且没有把自己的机型加进去,没有夹带私货,我们也选择了不同的场景,包括厨房场景、居家场景、学校场景,同时测试对象也各有不同,有柔性物体、刚性物体、记忆的任务。通过这样的方式也吸引了非常多的同行参加评测。以Table 30这个任务为例,大家可以在榜单上看到非常多的具身公司都尝试进行提交,我们也希望通过这样的方式,让大家看到今天模型的进展,所以这是我们做的第一步叫RoboChallenge的Table 30。
那这个评测是怎么做的呢?我们评测方法叫Specialist,大家想象的机器人是你告诉它应该干什么,它就可以在任意环境、任意对象开始干,这才是一个机器人的对象,我们称这种叫作零样本测试,应该是开箱即用,但今天所有的评测属于specialist的测试,什么意思,就是我们其实有一个具身的基座模型,今天希望让模型来做洗碗这个动作,比如说我们需要收集一系列的洗碗数据,针对这个模型再去做后训练,变成针对洗碗这个任务的专家模型叫Specialist,我们再去做它的成功性的测试,所以我们刚才看到Table30有三十个任务,实际上你测试的不是一个模型,而是30个模型,这个其实离我们想要实现的智能还有蛮大的距离。
Table 30这套测评差不多运行了一年多的时间,我们也走向更强大的状态,也就是Generalist,我们希望这三十个任务只用一个模型来做,不能只针对一个任务做一个专家模型,某种程度是过拟合的状态,我们希望这种模型可以看到相应的任务数据,所以我们在RoboChallenge推出了Generalist的评测之后,可以看测试出来的水平马上下降了一截,但这恰恰是我们迈向真正具身智能的必经之路。
所以从现在开始,RoboChallenge我们从专家模型、单任务模型全面切向了多任务模型,我们也会进一步推进零样本测试,在任意指令、任意环境下的评测。
我们在RoboChallenge也发现了很多有意思的观察,今天的模型在刚性任务上还是比较容易做的,但在柔性任务上比方说处理毛巾、衣服这些,它的成功率低很多,所以我们在新版的评测中也增加了很多叠衣服,比如说粘猫毛以及打绳结这些柔性任务,希望通过更复杂的任务推动更合理化、更有难度、更代表今天具身智能的评测,所以我们正式推出了Table30 V2,从单任务走向了多任务,我们增加了双臂协作的任务,也多元化增加了机型,我们相信,具身模型可以跨本体,就像人不仅用双手可以完成很多任务,拿筷子依然可以完成很多任务,这是我们当下希望推动的智能。
在这里分享一些数据,RoboChallenge运行至今,在我们平台上已经进行了数万次的测试,汇聚了来自中国、美国、新加坡、日本、阿联酋等多个国家的公司参与。在今年2月份,我们发布了一版RoboChallenge的年度报告,这个年度报告详细阐述了各项评测下算法的真实性能表现。我们可以看到很多刚性场景已经做得很不错了,像pick and place这些,但柔性物体的处理难度依然很大,但即便我们的模型是在单任务的模型上,当前的成功率还只有64%,不是99%,基于这样的现状,所以我们很难讲具身智能是不是迎来所谓的ChatGPT时刻,我们要让这个Scaling Law能够更快速地往前发展,需要让我们的模型变得更加智能,这样才能让具身智能更早一天来到我们的身边。
同时我们也联合合作伙伴们,RoboChallenge已经在CVPR和ICRA进行了两场比赛,在这样的比赛里也收获了大量的Table30 V2的任务和各类场景化的任务,我们推了很多官方重磅赛事,也收获了很高的关注度,这两次赛事吸引了来自十多个国家,超500名开发者,完成了超过500个算法的提交和评测。
所以,某种程度上RoboChallenge已经成为全球最大规模真机比赛的国际平台,我们也希望它从评测平台逐渐发展为连接整个具身智能社区的基础设施。所以在硅谷、欧洲以及英伟达GTC大会期间启明创投的活动上,我们跟很多开发者和同行进行交流。此外,RoboChallenge也跟工信部信通院一起在联合国AI for Good大会上,发布了EAI Bench,该项目是由工信部领导下的信通院作为专业的评测机构主导,它的技术支持是由RoboChallenge来提供的。
我们的目标就是希望能够通过这种方式,去建立一个中立、公益、非营利的具身智能平台,当然有人会问了,原力灵机不是一家做模型的公司吗?你们到底是裁判还是运动员?我想说,首先我们肯定不配做裁判,我们也不是任何一家公司的裁判,但我认为,今天具身智能的发展需要我们脚踏实地,与很多公司一起进步,但任何一家模型公司如果不知道如何去评测,就不可能把模型做好。放到整个行业层面,如果我们不知道如何去进行评测,也就很难把这个技术往前推进,所以我们非常需要这样一个评测的体系,来推进整个行业进步,让我们能够早日走到具身智能那一天。
所以接下来我们会把RoboChallenge打造成为公益、中立的平台,我们也特别感谢启明创投,接下来他们也会在这样的平台上扮演很重要的角色参与进来。
我们希望能够通过评测的方式驱动创新,我们也希望通过这样开放的方式把很多的标准工作做起来,促进产学研的联动,让更多场景方看到今天的模型走到了哪一步,推动机器人技术进一步落地现实。
原力灵机是一家具身智能的模型公司,我们的目标不是做评测,但我们认为做评测很重要,因为这样大家才能进步,所以我们公益性地在做这件事情,也欢迎大家体验我们在两周前发布的DM05模型。
我认为到7月份之前,国内所有公司发表的开源具身模型都没有π0.5好用,所以大家会看到很多公司对外宣称,我们在榜单上超越了π0.5,但实际上有多少开发者会抛弃π0.5,抛弃美国模型,使用中国的模型呢?非常不幸,没有,所以我们需要非常客观、真实、求真务实的态度,脚踏实地往前推进,我们希望通过一个又一个模型迭代,通过评测方式,和大家一起向前。